
Übersicht
- Was ist Hermes Agent?
- Hermes installieren: erst den einfachen Chat testen
- Hermes mit GPT verbinden
- Ollama: der schnelle Einstieg für ein lokales Modell
- llama-server und llama-swap: mehrere Modelle über einen Endpunkt
- Lokal betrieben heißt nicht automatisch vollständig offline
- Memory, SOUL.md, Skills und Projektanweisungen
- Wann sich Skills, Telegram und Zeitpläne lohnen
- So prüfen Sie einen lokalen Hermes-Aufbau
- Fazit: Ollama für den Start, llama-swap für den eigenen Mehrmodell-Stack
- Häufige Fragen zu Hermes Agent und lokaler KI
- Quellen und Stand
Hermes Agent lässt sich mit einem gehosteten Modell wie GPT oder mit einem lokalen Sprachmodell verbinden. Entscheidend ist die Unterscheidung zwischen Agent, Modell und Modellserver: Hermes plant Aufgaben und nutzt Werkzeuge. Das Sprachmodell liefert Antworten und entscheidet über den nächsten Schritt. Ollama oderllama-serverstellen ein Modell als lokalen Dienst bereit.llama-swapkann mehrere kompatible Modellserver hinter einem gemeinsamen Endpunkt verwalten. Läuft die Inferenz auf eigener Hardware, ist das Modell lokal; wird GPT über einen Cloud-Anbieter aufgerufen, bleibt die Inferenz cloudbasiert – auch wenn Hermes selbst auf dem eigenen Rechner läuft. [1] [2]
Ollama undllama-serversind dabei zwei Wege, ein lokales Modell bereitzustellen.llama-swapist kein drittes Modell und kein Ersatz fürllama-server, sondern eine zusätzliche Routing-Schicht. Für einen schnellen Test ist Ollama bequem. Wer mehrere GGUF-Modelle kontrolliert laden und über einen Endpunkt umschalten möchte, kannllama-servermitllama-swapkombinieren. Hermes unterstützt beide Wege über einen Custom Endpoint. [2]
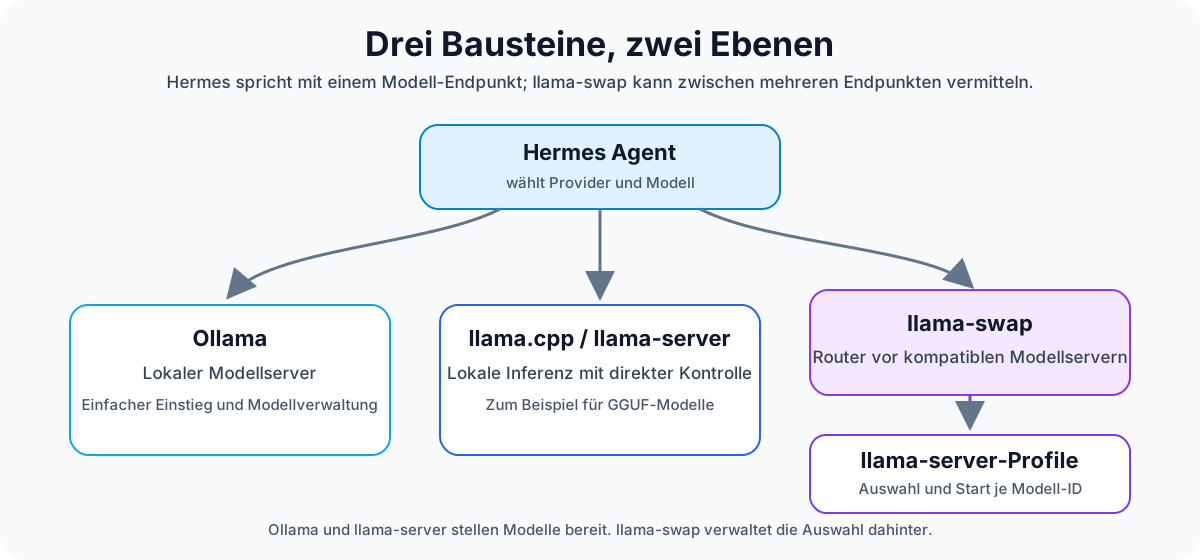
Ollama und llama-server stellen Modelle bereit; llama-swap kann mehrere Server hinter einem Endpunkt verwalten.
Begriffe sauber trennen:llama.cppist die Laufzeitumgebung,llama-serverihr HTTP-Server. „Llama“ bezeichnet außerdem eine Modellfamilie von Meta. Ein Qwen- oder Gemma-Modell wird nicht dadurch zu einem Llama-Modell, dass es mitllama.cppausgeführt wird.
Was ist Hermes Agent?
Hermes Agent ist ein quelloffener KI-Agent von Nous Research. Ein gewöhnlicher Chatbot antwortet vor allem auf eine einzelne Nachricht. Hermes kann – abhängig von den eingeschalteten Werkzeugen und dem verwendeten Modell – zusätzlich Dateien lesen, Befehle ausführen, im Web recherchieren, wiederverwendbare Skills verwenden und sich über Messaging-Dienste ansprechen lassen. Auch geplante Aufgaben sind möglich. [4]
Der Agent ist dabei nicht das Modell. Hermes steuert den Arbeitsablauf; ein Modell wie GPT, Claude, Qwen oder ein anderes kompatibles Modell verarbeitet die Anfrage. Werkzeuge verbinden Hermes mit Dateien, Terminal, Browser oder externen Diensten. Welche Daten dabei nach außen gelangen, hängt deshalb nicht nur vom Modell ab, sondern auch von den aktivierten Werkzeugen und Integrationen.
Hermes installieren: erst den einfachen Chat testen
Auf macOS und Windows empfiehlt die aktuelle Hermes-Dokumentation den Hermes-Desktop-Installer. Für Linux, macOS und WSL2 ist daneben die Installation über das offizielle Skript dokumentiert:
curl -fsSL https://hermes-agent.nousresearch.com/install.sh | bash
Nach der Installation richten Sie den Modellanbieter im Terminal ein:
hermes model
Starten Sie danach eine Unterhaltung:
hermes --tui
Prüfen Sie zuerst, ob Hermes mit dem ausgewählten Modell eine normale Antwort geben kann. Erst danach sollten Sie weitere Funktionen wie Telegram, Cronjobs oder zusätzliche Skills konfigurieren. Die offizielle Kurzanleitung empfiehlt diese Reihenfolge, weil Fehler bei Anmeldung, Modellname oder Endpunkt sonst schwerer einzugrenzen sind. [1]
Hermes mit GPT verbinden
Hermes bietet mehrere Wege zu gehosteten Modellen. Die aktuelle Dokumentation führt OpenAI Codex als Anbieter auf: Die Anmeldung erfolgt über den ChatGPT- oder Codex-Abonnementweg per OAuth; damit werden Codex-Modelle verwendet. Daneben gibt es einen direkten OpenAI-API-Zugang, der einen API-Schlüssel nutzt. Diese Wege sind nicht dasselbe. Vor allem sollten Sie nicht annehmen, dass ein ChatGPT-Abonnement unbegrenzte Hermes-Nutzung einschließt: Die aktuelle Anbieter-Dokumentation beschreibt die Anmeldemethode, aber nicht abschließend, welche Kontingente oder Kosten bei jeder Nutzung gelten. Prüfen Sie die Bedingungen des Anbieters, bevor Sie regelmäßige oder umfangreiche Aufgaben einrichten. [2]
Für die Einrichtung öffnen Siehermes model, wählen den gewünschten Anbieter und folgen dem Anmeldedialog. Welche Modelle tatsächlich angezeigt werden und verfügbar sind, kann sich ändern. Ein Modellname aus einem Video ist daher keine verlässliche Installationsanweisung für den heutigen Stand.
Ollama: der schnelle Einstieg für ein lokales Modell
Wenn Sie die Modellberechnung auf eigener Hardware ausführen möchten, ist Ollama ein einfacher Einstieg. Hermes verbindet sich über einen Custom Endpoint; der Modellname muss mit dem Namen übereinstimmen, den Ollama meldet. Die Hermes-Dokumentation beschreibt Ollama als lokalen Anbieter für schnelle Tests und zeigt den OpenAI-kompatiblen Endpunkt unterhttp://localhost:11434/v1. [2]
Installieren Sie Ollama und laden Sie ein Modell, das Ihre Hardware bewältigen kann. Ersetzen Sie den Platzhalter durch einen Modellnamen aus der Ollama-Bibliothek:
ollama pull <modellname>
Prüfen Sie, wie Ollama das Modell führt:
ollama list
Stellen Sie sicher, dass der Ollama-Dienst läuft. Die offizielle Hermes-Anleitung verwendet für einen lokalen Ollama-Endpunkt die Adressehttp://localhost:11434/v1. Öffnen Siehermes model, wählen Sie Custom endpoint (self-hosted / VLLM / etc.), tragen Sie den Endpunkt und den exakten Modellnamen ein. Bei einer lokalen Ollama-Installation ist normalerweise kein API-Schlüssel nötig. [2]
Prüfen Sie das Kontextfenster. Die aktuelle Hermes-Kurzanleitung nennt mindestens 64.000 Tokens als Voraussetzung für das Modell. Bei Ollama muss die Kontextlänge am Modellserver eingestellt werden; sie lässt sich nicht einfach über den OpenAI-kompatiblen Chat-Endpunkt erhöhen. Die Hermes-Anbieterdokumentation zeigt beispielsweiseOLLAMA_CONTEXT_LENGTH=64000für einen entsprechend gestarteten Ollama-Dienst. Das ersetzt keine Prüfung der Modellgrenzen und des verfügbaren Arbeitsspeichers. [1] [2]
OLLAMA_CONTEXT_LENGTH=64000 ollama serve
Ein größeres Kontextfenster kann mehr Speicher beanspruchen. Eine Angabe von 64.000 Tokens allein garantiert deshalb weder eine passende Modellkonfiguration noch ausreichende Geschwindigkeit. Modell, Quantisierung, Kontextlänge und verfügbare Hardware müssen zusammenpassen.
Wichtig bei Docker oder einem zweiten Rechner:localhostbezeichnet immer den Rechner beziehungsweise Container, in dem Hermes gerade läuft. Wenn Ollama auf einem anderen Gerät steht oder Hermes in einem Docker-Container arbeitet, istlocalhost:11434nicht automatisch der Ollama-Server. Verwenden Sie dann einen aus Hermes’ Umgebung erreichbaren privaten Endpunkt und prüfen Sie die Netzwerkfreigabe. Stellen Sie einen lokalen Modellserver nicht ungeschützt ins öffentliche Internet.
Der Ollama-Weg eignet sich, wenn Sie zunächst ein einzelnes Modell starten und die Verbindung testen wollen. Betreiben Sie bereitsllama.cppoder mehrere Modellserver, können Sie Hermes stattdessen direkt oder überllama-swapanbinden.
llama-server und llama-swap: mehrere Modelle über einen Endpunkt
Für eine kontrollierbare GGUF-Installation kann Hermes direkt mitllama-serversprechen. Wenn mehrere Modelle bereitstehen sollen, kommtllama-swapdavor: Hermes sendet Anfragen an einen gemeinsamen OpenAI-kompatiblen Endpunkt;llama-swapliest die Modell-ID aus der Anfrage und startet beziehungsweise wählt den dazu konfigurierten Server. Es kann Modelle nach einer definierten Leerlaufzeit entladen. So muss nicht jederllama-serverdauerhaft laufen. [2] [6]
Das entspricht dem hier beschriebenen Praxisaufbau: Hermes läuft auf dem Arbeitsrechner; die lokale Inferenz kann auf einem Mac oder einer separaten KI-Box laufen. In der Mehrmodell-Variante stelltllama-swapden erreichbaren Endpunkt bereit und verwaltet die dahinterliegendenllama-server-Prozesse. Die konkrete Modell-ID und die URL müssen zu Ihrer Konfiguration passen. Private Hostnamen, IP-Adressen und Zugangsdaten gehören nicht in eine öffentliche Anleitung.
In meinem Aufbau gibt es zwei Varianten:
| Einsatz | Dienst | Endpunkt | Konfiguration |
|---|---|---|---|
| Modell direkt auf dem Mac testen | llama-server | http://127.0.0.1:8080/v1 | GPT-OSS 20B als GGUF, 65.536 Kontext, ein Parallel-Slot, Metal und--jinjafür Tool-Aufrufe. |
| Mehrere Modelle auf der KI-Box nutzen | llama-swapvorllama-server | http://<privater-host>:8081/v1 | Ein OpenAI-kompatibler Zugang für mehrere Modellprofile, darunter Qwen- und Gemma-Modelle. Hermes bekommt die Modell-ID des ausgewählten Profils. |
Der Endpunkt127.0.0.1funktioniert nur für Hermes auf demselben Rechner oder in derselben Netzwerkumgebung. Greift Hermes vom Mac auf die KI-Box zu, muss dort die private, von Hermes erreichbare Adresse eingetragen werden. Die tatsächliche Serveradresse bleibt installationsabhängig; ein privater Tailscale-Name ist ein mögliches Beispiel, keine Pflicht.
Der kurze API-Test mit einer kleinenmax_tokens-Zahl prüft zunächst nur Verbindung und Modellstart. Für Hermes reicht das nicht als Funktionstest: Prüfen Sie anschließend einen längeren Dialog und einen echten, erlaubten Werkzeugaufruf. So erkennen Sie, ob Modelltemplate, Kontext und Tool-Aufruf tatsächlich zusammenspielen.
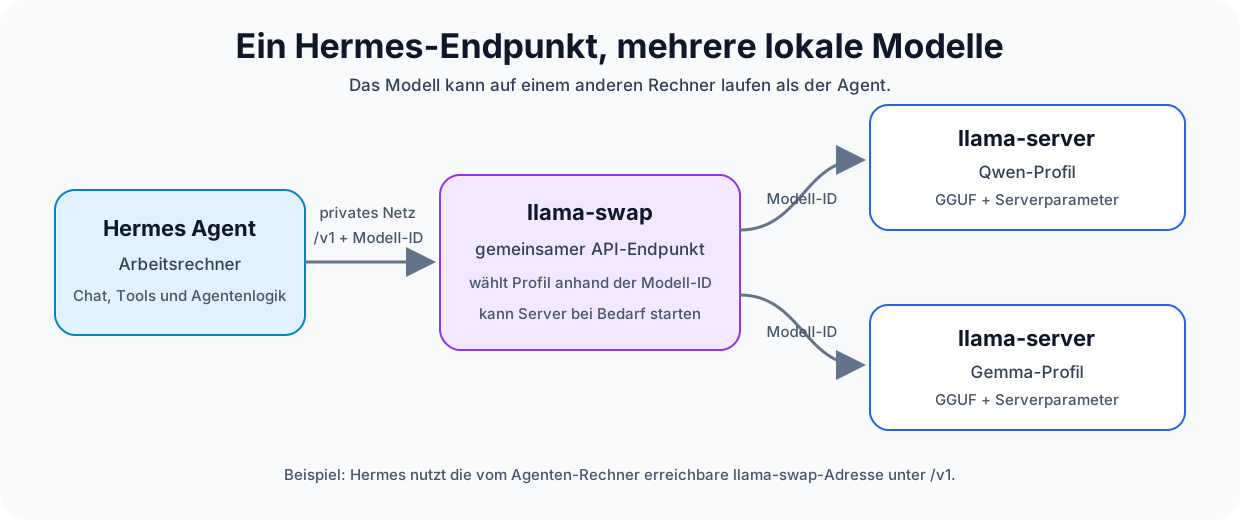
Ein Endpunkt für Hermes, dahinter ein passender Modellserver pro ausgewählter Modell-ID.
Hermes wird mithermes modeleingerichtet. Wählen Sie Custom endpoint (self-hosted / VLLM / etc.), tragen Sie die aus Hermes erreichbare Basis-URL ein und verwenden Sie die Modell-ID aus derllama-swap-Konfiguration:
Basis-URL: http://<erreichbarer-modellserver>:8081/v1
Modell-ID: <modell-id-aus-der-llama-swap-konfiguration>
Der Port8081ist ein Beispiel aus dem hier beschriebenen Aufbau; übernehmen Sie ihn nur, wenn Ihr Dienst dort lauscht. Läuft Hermes auf einem anderen Gerät, istlocalhostfalsch: Die Adresse muss vom Rechner oder Container aus erreichbar sein, in dem Hermes läuft. Ein privates Netz wie Tailscale kann dafür geeignet sein; begrenzen Sie den Zugang auf die beteiligten Geräte.
Beillama-serversind für Hermes zwei Einstellungen besonders wichtig:
- Kontext pro Sitzung: Die aktuelle Hermes-Dokumentation verlangt mindestens 64.000 Tokens. Stellen Sie das Fenster am Modellserver ein und prüfen Sie, was tatsächlich aktiv ist. Beillama.cppwird der Kontext über-cgesetzt. Wenn Sie parallele Slots konfigurieren, teilt der Server den Gesamtkontext auf die Slots auf. [1] [2]
- Tool-Aufrufe: Die Hermes-Anleitung nennt--jinjaals erforderlich. Ohne die Option kannllama-serverWerkzeugaufrufe als JSON-Text ausgeben, statt sie als Tool-Aufruf an Hermes zu übergeben. Testen Sie daher neben einem normalen Chat mindestens einen erlaubten Tool-Aufruf. [2]
Ein robuster Verbindungstest prüft vier Dinge getrennt: Ist die Basis-URL aus Hermes’ Netzwerk erreichbar? Meldet der Endpunkt die erwartete Modell-ID? Ist das geforderte Kontextfenster wirklich aktiv? Kann das Modell einen Werkzeugaufruf ausführen? So lässt sich ein Netzwerkfehler von einem Modell-, Kontext- oder Template-Problem unterscheiden.
Lokal betrieben heißt nicht automatisch vollständig offline
„Hermes lokal nutzen“ kann Verschiedenes bedeuten:
- Hermes läuft lokal, GPT läuft in der Cloud: Die Agentensoftware ist auf dem eigenen Rechner installiert; Anfragen an das Modell gehen an den Cloud-Anbieter.
- Hermes läuft auf einem VPS oder Mac, der Modellserver auf eigener Hardware: Der Agent und die Inferenz laufen auf verschiedenen Geräten. Die Verbindung zwischen ihnen muss erreichbar und abgesichert sein.
- Hermes und Modellserver laufen auf demselben Rechner: Die Modellberechnung kann lokal bleiben. Externe Websuche, Messaging, Sprachdienste oder andere Integrationen können trotzdem Daten an Dritte übertragen.
Die konkrete Datenverarbeitung hängt von der gesamten Konfiguration ab. Ein lokales Modell allein macht nicht automatisch jede Agentenfunktion offline oder datenschutzsicher. Prüfen Sie für jede Integration, wohin Anfragen und Dateien gesendet werden.
Memory, SOUL.md, Skills und Projektanweisungen
Hermes kann über mehrere Sitzungen hinweg Informationen berücksichtigen. Die Begriffe dafür beschreiben unterschiedliche Aufgaben:
- MEMORY.md enthält ausgewählte Fakten zum Arbeitsumfeld, zu Projekten und zu erprobten Abläufen.
- USER.md hält das Nutzerprofil fest, etwa Kommunikationsstil und Präferenzen.
- SOUL.md prägt Identität und Stimme des Agenten.
- Skills sind wiederverwendbare Anleitungen für konkrete Aufgaben. Hermes kann sie bei Bedarf laden, statt jede Anleitung in jede Unterhaltung zu übernehmen.
- AGENTS.md und weitere Kontextdateien liefern projektbezogene Regeln. Sie sind Projektkontext, keine zusätzliche Memory-Datei. [3] [4]
Hermes lädt die eingebauten Memory-Dateien laut Dokumentation zu Beginn einer neuen Sitzung in den Kontext. Änderungen während einer laufenden Sitzung werden für die nächste Sitzung sichtbar. Für die Suche nach Einzelheiten in früheren Gesprächen gibt es die getrennte Session-Suche. Memory ist somit kein vollständiges Archiv und auch kein Training des Sprachmodells. [3]
Der oft beschriebene „Selbstverbesserungs-Kreislauf“ bedeutet vor allem: Wiederkehrende Korrekturen können in Memory oder in einem Skill festgehalten werden. Das ändert Anweisungen und verfügbaren Kontext, aber nicht automatisch die Modellgewichte. Prüfen Sie gespeicherte Inhalte regelmäßig auf Richtigkeit und Aktualität; veraltete Hinweise können den Agenten in die falsche Richtung lenken. [3]
Wann sich Skills, Telegram und Zeitpläne lohnen
Ein Skill ist sinnvoll, wenn eine Aufgabe wiederholt nach denselben Schritten erledigt werden soll: zum Beispiel ein Rechercheablauf, eine regelmäßige Projektprüfung oder ein definierter Veröffentlichungsprozess. Ein Skill beschreibt, wie eine Aufgabe erledigt wird; Memory hält fest, was der Agent über Nutzer, Umgebung oder Projekt wissen soll. [4]
Wenn Hermes aus einem Messenger erreichbar sein soll, können Sie nach dem erfolgreichen Basistest ein Gateway einrichten. Geplante Aufgaben eignen sich für wiederkehrende Abläufe, etwa eine regelmäßige Zusammenfassung oder eine Prüfung mit anschließender Benachrichtigung. Beides erhöht den Nutzen – und die Verantwortung: Prüfen Sie Empfänger, Berechtigungen, Ausführungszeit und mögliche Kosten, bevor solche Abläufe unbeaufsichtigt laufen. [1] [4]
Für mehrere Assistenten mit unterschiedlichen Rollen können getrennte Profile oder getrennte Hermes-Umgebungen sinnvoll sein. Die Memory-Dokumentation warnt davor, mehrere Agentenprozesse auf dasselbe Hermes-Home-Verzeichnis zeigen zu lassen. Docker kann zusätzlich helfen, Terminalaktionen in einer Sandbox auszuführen; es ist jedoch kein Ersatz für begrenzte Berechtigungen, sorgfältigen Umgang mit Zugangsdaten und eine geprüfte Netzwerkkonfiguration. [1] [3]
So prüfen Sie einen lokalen Hermes-Aufbau
Ein einzelner erfolgreicher Chat reicht für eine belastbare Einschätzung nicht aus. Prüfen Sie mindestens:
- Zeigt Hermes den erwarteten Provider und Modellnamen an?
- Funktioniert eine normale Unterhaltung über mehrere Nachrichten?
- Kann das Modell einen ausdrücklich erlaubten Werkzeugaufruf zuverlässig ausführen?
- Bleibt die Verbindung nach einem Neustart bestehen?
- Ist die konfigurierte Kontextlänge am Modellserver tatsächlich aktiv?
- Sind externe Werkzeuge, Tokens und Zugriffsrechte auf das Notwendige begrenzt?
Wer die Leistungsfähigkeit unterschiedlicher Modelle vergleichen möchte, sollte Version, Modellname, Quantisierung, Kontextlänge, Laufzeitumgebung und Messmethode dokumentieren. Eine einzelne Token-pro-Sekunde-Zahl sagt wenig darüber aus, ob ein Modell die Werkzeuge zuverlässig aufruft oder längere Aufgaben gut bewältigt. Für einen redaktionellen Praxistest müssen daher konkrete Messwerte aus dem tatsächlichen Aufbau ergänzt werden; sie lassen sich nicht aus der Dokumentation oder aus der Hardwarebezeichnung ableiten.
Wer zunächst klären möchte, welche lokalen Modelle auf einem Apple-Silicon-Mac sinnvoll laufen, findet ergänzende Hinweise im bereits veröffentlichten NGO-Online-Beitrag Lokale KI auf dem Mac 2026.
Fazit: Ollama für den Start, llama-swap für den eigenen Mehrmodell-Stack
Hermes kann GPT-Modelle über einen unterstützten Cloud-Anbieter oder lokale Modelle über einen kompatiblen Endpunkt nutzen. Ollama ist der leicht zugängliche Startpunkt für einen einzelnen lokalen Modellserver.llama-serverbietet direkten Zugriff auf die Einstellungen derllama.cpp-Laufzeit.llama-swapergänzt diesen Weg, wenn mehrere Modellserver über eine gemeinsame Adresse erreichbar sein und Modelle bei Bedarf gewechselt oder entladen werden sollen. Diese Bausteine lösen unterschiedliche Aufgaben und sollten im Artikel nicht als gleichartige Produkte dargestellt werden. [2] [6]
Die wichtigste Entscheidung lautet deshalb: Wo läuft Hermes, wo wird das Modell berechnet und welche Werkzeuge dürfen auf welche Daten zugreifen? Für ein einzelnes Modell ist Ollama ein einfacher Startpunkt. Wenn Sie mehrere lokale Modelle über einen Endpunkt anbieten möchten, istllama-servermitllama-swapeine flexible Alternative. Ob Ollama mehr Suchvolumen alsllama-serveroderllama-swaphat, lässt sich aus dem bisher gelieferten Keyword-Ausschnitt nicht ableiten.
Häufige Fragen zu Hermes Agent und lokaler KI
Kann Hermes Agent ein lokales KI-Modell nutzen?
Ja. Hermes kann überhermes modelmit einem Custom Endpoint verbunden werden. Der Endpunkt muss aus der Umgebung erreichbar sein, in der Hermes läuft, und das Modell muss die Mindestanforderung an das Kontextfenster erfüllen. [1] [2]
Funktioniert Hermes Agent mit Ollama?
Ja. Die offizielle Hermes-Anbieterdokumentation beschreibt Ollama über einen OpenAI-kompatiblen Custom Endpoint, standardmäßig unterhttp://localhost:11434/v1. Bei Docker oder einem getrennten Server kann eine andere, erreichbare Adresse nötig sein. [2]
Kann Hermes Agent mit llama.cpp oder llama-server arbeiten?
Ja.llama-serverwird in der aktuellen Hermes-Dokumentation ausdrücklich als lokaler Modellserver beschrieben. Hermes verbindet sich über einen Custom Endpoint; für Werkzeugaufrufe nennt die Anleitung--jinjaund für den Kontext mindestens 64.000 Tokens. [1] [2]
Wofür brauche ich llama-swap?
llama-swapist eine Routing-Schicht für kompatible Modellserver. Sie kann anhand der angefragten Modell-ID den passenden Server starten oder auswählen und Modelle nach einer konfigurierten Leerlaufzeit entladen. Für nur ein dauerhaft laufendes Modell brauchen Sie diese zusätzliche Schicht nicht zwingend. [6]
Was ist der Unterschied zwischen Hermes und GPT?
Hermes ist der Agent, der Werkzeuge und Arbeitsabläufe steuert. GPT ist ein Modell, das Hermes als Provider nutzen kann. Wird GPT in der Cloud ausgeführt, ist die Inferenz nicht lokal – auch wenn Hermes selbst auf dem eigenen Rechner läuft.
Wie viel Kontext braucht Hermes Agent?
Die aktuelle Hermes-Kurzanleitung nennt mindestens 64.000 Tokens Kontext. Bei Ollama muss die passende Kontextlänge serverseitig eingestellt werden. Ob ein Modell und die vorhandene Hardware diesen Wert sinnvoll bewältigen, muss gesondert geprüft werden. [1] [2]
Was unterscheidet SOUL.md, Memory und Skills?
SOUL.md prägt die Stimme und Identität des Agenten. USER.md und MEMORY.md enthalten ausgewählte Nutzer- beziehungsweise Umgebungsinformationen. Skills beschreiben wiederholbare Verfahren. Projektdateien wie AGENTS.md ergänzen Regeln für ein bestimmtes Projekt. [3] [4]
Quellen und Stand
Die technischen Aussagen wurden am 7. Oktober 2026 anhand der offiziellen Hermes-Dokumentation geprüft. Die als aktuell ausgewiesene GitHub-Veröffentlichung war Hermes Agent v0.21.5 (Release v2026.9.24). Die Anbieter- und Installationsdetails können sich mit späteren Versionen ändern. [5]
| [1] | (1, 2, 3, 4, 5, 6, 7, 8, 9) Nous Research: Hermes Agent Quickstart. hermes-agent.nousresearch.com/docs/getting-started/quickstart |
| [2] | (1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14) Nous Research: LLM and Model Providers, insbesondere Abschnitte zu OpenAI Codex, Custom Endpoint und Ollama. hermes-agent.nousresearch.com/docs/integrations/providers |
| [3] | (1, 2, 3, 4, 5) Nous Research: Persistent Memory. hermes-agent.nousresearch.com/docs/user-guide/features/memory |
| [4] | (1, 2, 3, 4, 5) Nous Research: Features Overview. hermes-agent.nousresearch.com/docs/user-guide/features/overview |
| [5] | Nous Research: Hermes Agent v0.21.5, Release v2026.9.24. github.com/NousResearch/hermes-agent/releases/tag/v2026.9.24 |
| [6] | (1, 2, 3) mostlygeek: llama-swap README. github.com/mostlygeek/llama-swap |